캐싱은 데이터를 일시적으로 저장해 동일한 데이터가 다시 필요할 때 더 빠르게 액세스할 수 있도록 하는 기술입니다. 시스템은 동일한 정보를 원본 데이터 소스에서 반복적으로 가져오는 대신, 캐시 데이터라고 하는 저장된 복사본을 재사용합니다. 이를 통해 응답 시간을 단축하고 서버 요청 및 리소스 사용량을 줄일 수 있습니다.
캐싱은 웹 브라우저, 애플리케이션, 데이터베이스 및 콘텐츠 전송 네트워크(CDN) 등 다양한 환경에서 데이터 전송 속도를 높이고 리소스 사용을 최적화하는 데 널리 활용됩니다. 또한 많은 시스템에는 캐싱 기능이 기본적으로 내장되어 있어 별도의 스토리지 설정 없이도 성능을 향상시킬 수 있습니다.
캐싱은 어떻게 작동하나요?
캐싱은 자주 액세스하는 데이터의 복사본을 원본 데이터 소스보다 빠르게 가져올 수 있는 위치에 저장하는 방식으로 작동합니다. 동일한 데이터에 대한 요청이 다시 발생하면 시스템은 캐시에 재사용할 수 있는 데이터가 있는지 확인합니다.
일반적인 캐싱 프로세스는 다음과 같은 단계로 진행됩니다.
- 최초 요청: 사용자 또는 애플리케이션이 서버나 다른 데이터 소스에 데이터를 요청합니다.
- 캐시 확인: 시스템은 요청한 데이터가 이미 캐시에 저장되어 있는지 확인합니다.
- 캐시 미스: 요청한 데이터가 캐시에 없거나 만료된 경우, 시스템은 원본 데이터 소스에서 데이터를 가져와 복사본을 캐시에 저장합니다.
- 캐시 히트: 동일한 데이터에 대한 요청이 다시 발생하면 시스템은 원본 데이터 소스에 액세스하는 대신 캐시에서 직접 데이터를 가져옵니다.
- 캐시 만료: 캐시 데이터는 일반적으로 TTL(Time to Live) 값으로 설정된 일정 기간 동안 저장됩니다. TTL이 만료되면 최신 데이터로 캐시를 갱신할 수 있습니다.
캐싱에는 어떤 유형이 있나요?
캐싱은 데이터의 저장 위치와 액세스 방식에 따라 컴퓨팅 시스템의 다양한 계층에 구현할 수 있습니다. 주요 캐싱 유형은 다음과 같습니다.
브라우저 캐싱 및 CDN 캐싱
브라우저 캐싱: 웹사이트 리소스를 사용자의 디바이스에 저장하여 이후 방문 시 더 빠르게 불러올 수 있도록 하는 방식입니다. 일반적인 캐시 대상에는 HTML 페이지, 이미지, CSS 파일 및 JavaScript 파일이 포함됩니다.
CDN 캐싱: 웹사이트 콘텐츠의 복사본을 사용자와 가까운 엣지 서버에 저장하는 방식입니다. 이를 통해 이후 발생하는 요청을 캐시에서 직접 처리하여 원본 서버에 반복적으로 액세스할 필요를 줄입니다.
애플리케이션 캐싱, 메모리 캐싱 및 분산 캐싱
애플리케이션 캐싱: API 응답 및 데이터베이스 쿼리 결과와 같이 자주 요청되는 애플리케이션 데이터를 저장하여 동일한 처리 작업이나 데이터베이스 쿼리가 반복되는 것을 방지합니다.
메모리 캐싱: RAM(랜덤 액세스 메모리)에 자주 액세스하는 데이터를 저장하여 데이터 검색 속도를 높이는 방식입니다.
분산 캐싱: 네트워크 내 여러 서버 또는 노드에 캐시 데이터를 분산 저장하는 방식입니다. 이를 통해 애플리케이션이 공유 데이터에 효율적으로 액세스하고 더 많은 작업 부하를 처리할 수 있습니다.
CPU 캐싱, 디스크 캐싱 및 DNS 캐싱
CPU 캐싱: 자주 사용하는 명령어와 데이터를 프로세서 가까이에 있는 고속 메모리에 저장하여 데이터 액세스 속도를 높이는 방식입니다.
디스크 캐싱: 더 빠른 메모리를 활용해 자주 액세스하는 디스크 데이터를 일시적으로 저장함으로써 읽기 및 쓰기 성능을 향상시키는 방식입니다.
DNS 캐싱: 이전에 확인한 도메인 이름과 해당 IP 주소를 저장하여 반복적인 DNS 조회를 줄이고 도메인 이름 확인 속도를 높이는 방식입니다.
캐싱의 주요 이점은 무엇인가요?
데이터 액세스 속도 향상 및 지연 시간 감소
캐싱은 자주 요청되는 데이터를 사용자 또는 애플리케이션과 가까운 위치에 저장하여 원격 서버나 데이터베이스에서 정보를 가져오는 데 걸리는 시간을 줄입니다. 데이터 검색 경로가 짧아지면 응답 시간이 단축되고 사용자 경험이 향상됩니다.
서버 부하 및 대역폭 사용량 감소
캐시된 응답을 활용하면 원본 서버가 동일한 요청을 반복적으로 처리하거나 같은 데이터를 여러 번 전송할 필요가 없습니다. 원본 서버에 대한 요청과 데이터 전송이 줄어들면서 서버 부하, 네트워크 트래픽 및 대역폭 사용량을 절감할 수 있습니다.
확장성 향상 및 운영 비용 절감
캐시 데이터를 통해 반복적인 요청을 처리하면 서버 용량을 비례적으로 늘리지 않고도 더 많은 사용자의 요청에 대응할 수 있습니다. 이를 통해 기업은 트래픽 급증에 보다 효율적으로 대응하고 인프라 리소스 활용을 최적화하며 운영 비용을 절감할 수 있습니다.
캐싱의 활용 사례
캐싱은 일상적인 디지털 서비스부터 다양한 컴퓨팅 환경에 이르기까지 폭넓게 활용됩니다. 대표적인 사례는 다음과 같습니다.
- 웹사이트 재방문: 브라우저는 이전에 다운로드한 이미지와 CSS 파일을 로컬 캐시에서 불러와 모든 리소스를 다시 요청하지 않아도 되도록 합니다.
- 동영상 스트리밍: 동영상 스트리밍 플랫폼은 재생 중인 동영상 세그먼트를 캐싱하여 콘텐츠를 더 빠르게 가져오고 콘텐츠 서버에 대한 반복적인 요청을 줄입니다.
- 데이터베이스 쿼리: 애플리케이션은 동일한 데이터베이스 쿼리를 반복적으로 실행하는 대신 캐시에서 자주 요청되는 쿼리 결과를 가져옵니다.
- 도메인 이름 확인: DNS 리졸버는 캐시된 IP 주소 레코드를 활용하여 요청이 발생할 때마다 새로운 조회를 수행하지 않아도 되도록 합니다.
- 웹사이트 콘텐츠 전송: CDN은 원본 서버에서 매번 콘텐츠를 가져오는 대신 가까운 엣지 서버에서 캐시된 이미지, 스크립트 및 기타 웹사이트 리소스를 제공합니다.
CDN 캐시란 무엇인가요?
CDN 캐시는 콘텐츠 전송 네트워크(CDN)의 엣지 서버에 마련된 임시 저장 공간으로, 이미지, 동영상, JavaScript 파일, CSS 파일 및 기타 캐싱 가능한 리소스 등 웹사이트 콘텐츠의 복사본을 저장합니다.
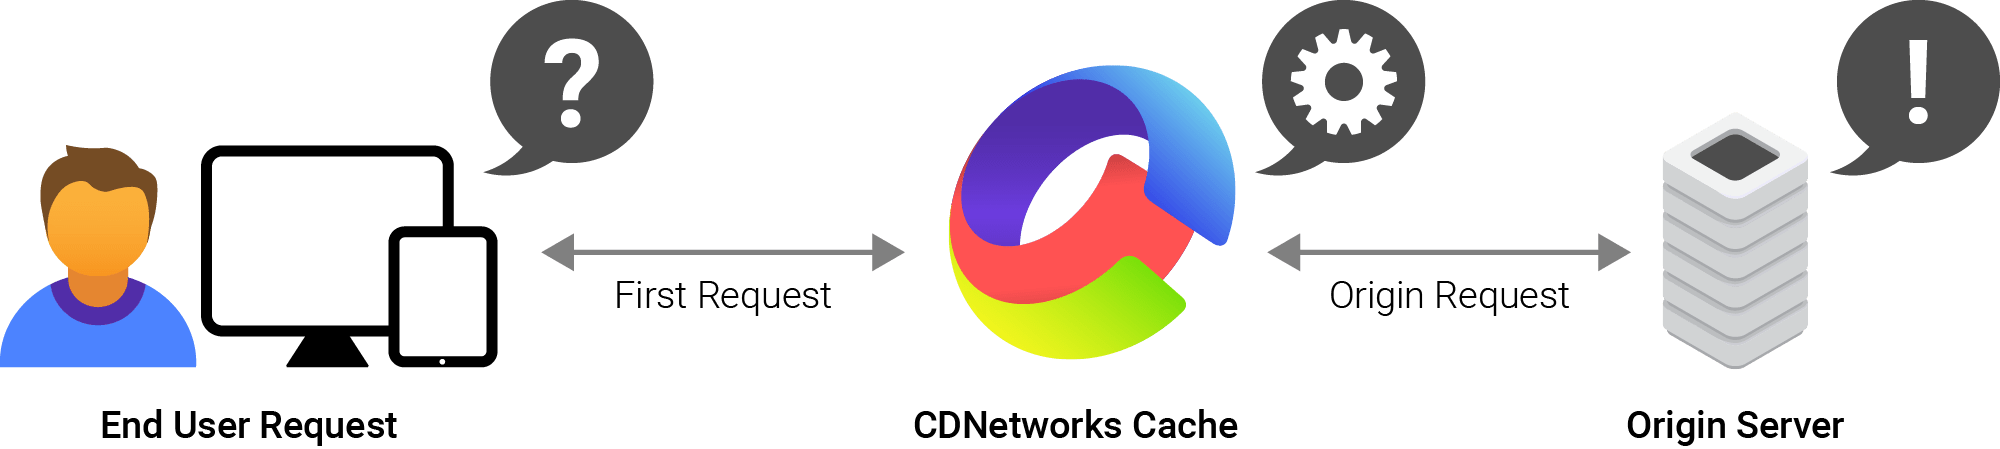
CDN 캐싱은 서로 다른 지리적 지역에 위치한 여러 엣지 서버에 캐시된 콘텐츠를 저장하고 분산하는 방식으로 작동합니다. 사용자가 콘텐츠를 요청하면 CDN은 라우팅 설정과 네트워크 상태를 기반으로 적절한 엣지 서버로 요청을 전달합니다.
요청한 콘텐츠의 유효한 복사본이 캐시에 존재하면 캐시 히트가 발생하며, CDN은 캐시된 콘텐츠를 사용자에게 직접 전송합니다.
반면 콘텐츠가 캐시에 없거나 만료된 경우에는 캐시 미스가 발생합니다. 이때 CDN은 원본 서버에서 콘텐츠를 가져온 후 이후 요청에 대비해 해당 복사본을 캐시에 저장합니다.
CDNetworks는 CDN 캐싱을 어떻게 지원하나요?
CDNetworks는 전 세계에 분산된 3,000개 이상의 PoP(Point of Presence)를 기반으로 CDN 서비스를 제공합니다. 각 PoP에는 엣지 서버가 구축되어 있어 최종 사용자와 가까운 위치에서 웹사이트 콘텐츠를 캐싱하고 전송합니다. 이를 통해 기업은 지연 시간을 줄이고 다양한 지역에서 콘텐츠 전송 성능을 향상시킬 수 있습니다.
CDNetworks의 CDN 서비스에 대해 자세히 알아보세요.
FAQ
동적 콘텐츠도 캐싱할 수 있나요?
네. 적절한 캐싱 규칙을 설정하면 동적 콘텐츠도 캐싱할 수 있습니다. 일반적인 방법으로는 API 응답 캐싱, 사용자별 캐시 키 설정 및 짧은 TTL 값 적용 등이 있으며, 이를 통해 자주 변경되거나 사용자별로 달라지는 데이터를 효과적으로 관리할 수 있습니다.
캐시 데이터가 만료되면 어떻게 되나요?
만료된 캐시 데이터는 더 이상 유효한 캐시 항목으로 제공되지 않습니다. 새로운 요청이 들어오면 시스템은 원본 서버에서 최신 데이터를 가져와 이후 요청에 사용할 수 있도록 캐시에 저장합니다.
캐시와 쿠키의 차이점은 무엇인가요?
캐시는 웹사이트 리소스의 복사본을 저장하여 페이지 로딩 속도를 높이는 데 사용됩니다. 반면 쿠키는 세션 식별자 및 사용자 설정과 같이 사용자와 관련된 소량의 정보를 저장합니다. 캐시는 데이터 검색 효율을 높이는 데 목적이 있으며, 쿠키는 사용자 식별 및 세션 관리에 사용됩니다.